Was wir beim Bau eines Agent-Systems mit kleinen Modellen gelernt haben
Warum wir den Agent verkleinern wollten
Ein Modell mit 400M Parametern, feinjustiert auf rund 1.100 echte Nachrichten, kam bei einer Routing-Entscheidung im Produktivbetrieb bis auf 1,6 Punkte an ein allgemeines LLM mit 80B heran. Mit einem Confidence Gate, das unsichere Fälle an das LLM zurückgibt, war es gleichauf. Bis dahin brauchte es rund 30 Trainingsrunden, und das meiste, was wir unterwegs gelernt haben, hatte mit Modellarchitektur nichts zu tun.
Der Rahmen war ein Chat-Assistent im Produktivbetrieb. Jede Nachricht lief durch einen vollen LLM-Aufruf, dessen erste Aufgabe war zu entscheiden, wohin die Nachricht gehört. Daneben gab es eine Reihe handgeschriebener Regexes für kleinere Ja/Nein-Entscheidungen, und jede bekam nach jedem Vorfall eine Klausel dazu. Wir wollten wissen, ob kleine, spezialisierte Modelle diese Entscheidungen übernehmen können.
Dieser Beitrag zeigt, was gehalten hat, was nicht, und die Zahlen hinter beidem.
Lektion 1: Das LLM raus aus den Entscheidungen, aber für den Text behalten
Wenn ein Schritt in einem Agent eine feste Menge möglicher Antworten hat, braucht er kein generatives Modell. Eine Nachricht routen, einen erneuten Versuch erkennen, eine Folgefrage von einer neuen Frage unterscheiden: Jede dieser Aufgaben ist eine Klassifikation mit bekannten Labels. Ein kleiner Classifier erledigt so einen Schritt schneller und billiger, und er gibt für dieselbe Eingabe immer dieselbe Antwort.
LLMs sind immer noch das beste Werkzeug, um Text zu erzeugen: die Antwort selbst, eine Zusammenfassung, ein frei formuliertes Thema aus einem Satz herauslesen. Also lässt das Setup, das wir angestrebt haben, sie genau dort. Typisierte Entscheidungen gehen an kleine Modelle. Offener Text bleibt beim LLM. Wenn ein kleines Modell nicht sicher genug ist, springt das LLM ein.
Was du damit gewinnst:
- Durchsatz und Latenz. Eine Klassifikation ist ein Durchlauf durch einen Encoder, ohne Token-für-Token-Generierung.
- Kosten. Es läuft auf der CPU in deinem eigenen Backend, also ohne API-Rechnung pro Aufruf und ohne Rate Limit.
- Determinismus. Dieselbe Eingabe ergibt immer dasselbe Label und dieselbe Confidence. Das macht Tests, Regressionsprüfungen und Debugging viel einfacher als bei einer gesampelten LLM-Ausgabe.
- Weniger Regexes. Eine trainierte Entscheidung hält, wenn Leute anders formulieren. Eine Regex muss wieder geflickt werden.
Der Haken: Du sparst den Aufruf nur, wenn du ihn ganz ersetzt
Das hätten wir fast übersehen. Der LLM-Aufruf, den wir loswerden wollten, lieferte nicht eine Entscheidung. Er lieferte acht Felder: die Route plus sieben weitere, einige davon freie Textextraktion. Auch ein perfekter Route-Classifier lässt den Aufruf für jede Nachricht laufen, die die anderen sieben braucht. Als wir nachgesehen haben, hätten nur rund 4 % des Traffics allein über die Route den LLM-Aufruf ganz überspringen können.
Bevor du irgendwas trainierst, liste jedes Feld auf, das der Aufruf liefert, und jede Stelle im Code, die es liest. Dann plane entweder, alle abzudecken, oder teile den Prompt so, dass der deterministische Teil für sich stehen kann. Miss den Nutzen als eingesparte LLM-Aufrufe pro 1.000 Nachrichten, nicht als Modellgenauigkeit.
Diese Bestandsaufnahme hat sich noch auf eine zweite Art gelohnt. Der Aufruf, den wir untersucht haben, sortierte Nachrichten in sechs Labels, aber der Agent hat nur auf zwei davon reagiert, und alles andere lief denselben Weg. Ein Modell auf Unterscheidungen zu trainieren, die niemand liest, verschwendet Kapazität und erzeugt Fehler, die keine Rolle spielen. Aus unserem Problem mit sechs Klassen wurde eines mit drei.
Lektion 2: Kleine Modelle schlagen sich gut, aber Größe kauft dir die seltenen Fälle
Ein Encoder mit 17M Parametern lernte einfache, klar getrennte Entscheidungen in ein oder zwei Trainingsrunden. Bei einer echten Routing-Aufgabe mit schiefem Traffic stieß er an eine Grenze. Rund 88 % der Nachrichten nahmen eine Route, 10 % die zweite und 2 % die dritte. Das 17M blieb bei 82 bis 86 % Gesamtgenauigkeit hängen, egal was wir an den Daten geändert haben.
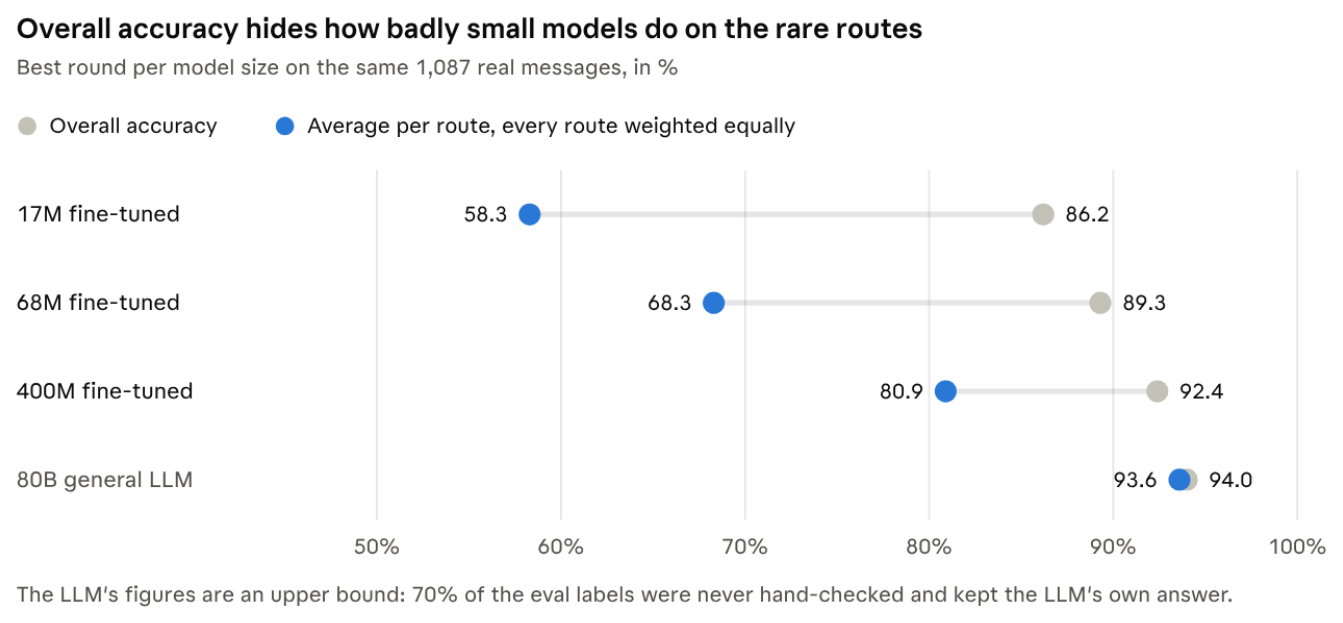
Von 17M auf 400M stieg die Gesamtgenauigkeit um 6 Punkte. Die Genauigkeit auf den seltenen Routen stieg um 23 Punkte. Ein Modell kann 86 % erreichen, indem es die häufige Route richtig macht, und die seltenen Routen trotzdem fast in der Hälfte der Fälle verfehlen. Beurteile die Modellgröße an den seltenen Klassen, nie an der Gesamtgenauigkeit.
Größe brachte auch Kalibrierung. Bei 17M kamen 100 der 150 Fehler des Modells mit einer Confidence von 0,99 oder höher. Bei 400M waren es 41 von 83. Das zählt mehr als die Genauigkeit, weil das Confidence Gate im nächsten Abschnitt nur funktioniert, wenn eine hohe Confidence auch etwas bedeutet.
Was Größe kostet
Größe kostet Latenz, und diese Kosten sind fix. Wir haben einzelne Requests auf einer fest zugewiesenen CPU mit 2 Kernen gemessen:
| Modell | Median-Latenz | p95-Latenz |
|---|---|---|
| 17M | 48 ms | 73 ms |
| 68M | 375 ms | 567 ms |
Das 400M braucht eine GPU. Einiges, was Inferenz normalerweise beschleunigt, hat hier nicht geholfen:
- Prefix Caching geht nicht. Die Aufgabenanweisung machte rund 70 % jeder Eingabe aus. In einem bidirektionalen Encoder hängt die Kodierung der Anweisung von der Nachricht danach ab, also wird sie bei jedem Aufruf neu kodiert. Eine kürzere Anweisung senkte die Median-Latenz um rund 40 %, kostete aber 2,2 Punkte.
- int8-Quantisierung hat 4,6 % der Entscheidungen umgedreht, wegen Ausreißern in den Aktivierungen. Beurteile Quantisierung danach, wie viele Entscheidungen sich ändern, nicht nur danach, wie weit sich die Wahrscheinlichkeiten verschieben.
- ONNX war exakt, aber nicht schneller als PyTorch auf der CPU, und Batching war pro Nachricht langsamer.
Distillation hat geholfen. Ein 68M-Student, trainiert auf den Soft Labels des 400M, behielt mehr Recall auf den seltenen Routen als ein 68M, das auf Hard Labels trainiert wurde. Das 17M konnte die seltenen Routen auch mit einem Teacher nicht lernen: Sein Recall darauf blieb unter 50 %.
Lektion 3: Ein feinjustiertes kleines Modell kann mit einem allgemeinen mithalten, mit Fallback
Für sich allein erreichte unser bestes feinjustiertes Modell (400M Parameter, rund 200-mal kleiner als das LLM) 92,4 % gegenüber 94,0 % beim LLM. Fine-Tuning schloss den Großteil der Lücke, aber nicht alles. Den Rest schloss erst, dass das kleine Modell nur entscheiden durfte, wenn es sicher war:
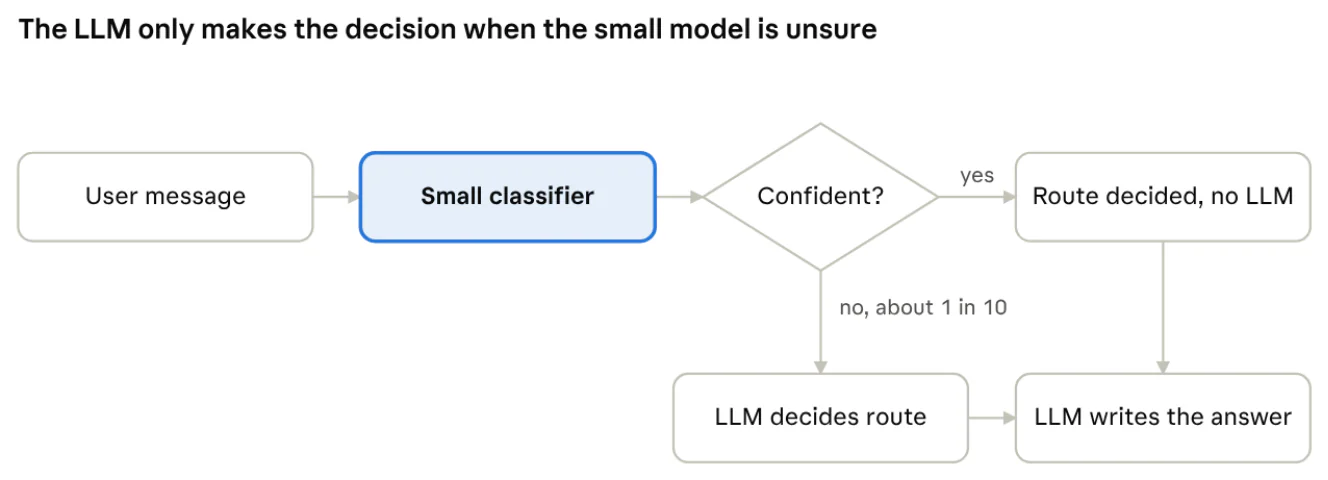
Bei einer Confidence-Schwelle von 0,99 beantwortete das 400M 90,6 % der Nachrichten selbst. Das LLM entschied die restlichen 9,4 %. Zusammen erreichten sie 94,4 %, gleichauf mit dem LLM allein, und neun von zehn Routing-Aufrufen ans LLM fielen weg.
Zwei Einschränkungen halten das ehrlich:
- Die Latte hat sich verschoben, als wir strenger wurden. Später haben wir die Evaluierung neu aufgebaut, mit unabhängigen Labels, einem versiegelten Test-Set und drei Trainings-Seeds. Unter diesen Regeln erreichte das beste Modell in CPU-Größe (ein 68M, destilliert aus dem 400M) mit Gate 90,8 % gegenüber 93,8 % beim LLM. Das reicht noch nicht zum Ausliefern. Die Ursache waren zu wenige Daten zu den seltenen Routen, nicht ein zu kleines Modell.
- Die Labels des LLM selbst waren systematisch falsch. Von 199 Nachrichten, die das LLM im Produktivbetrieb auf die Small-Talk-Route schickte, ordnete eine unabhängige Jury 65 der Daten-Route zu. Das war ein bekannter Bug im Produktivbetrieb. Hätten wir auf den Labels des LLM trainiert, hätte das kleine Modell den Bug gelernt. Unsere Gold Labels kamen stattdessen von einer blinden Jury: zwei verschiedene offene Modelle, jedes zweimal gefragt, mit den Antwortoptionen in beiden Reihenfolgen.
Schlägt Training also ein allgemeines Modell? Bei Kosten, Latenz und Determinismus eindeutig. Bei der Qualität kommt ein feinjustiertes Modell mit einigen hundert Millionen Parametern bis auf wenige Punkte heran. Ein Confidence Gate mit LLM-Fallback macht daraus ein Unentschieden.
Lektion 4: Dein eigenes Eval-Set schmeichelt dir
Auf unseren eigenen zurückgehaltenen Daten lagen die meisten kleinen Ja/Nein-Entscheidungen über 0,9, viele bei glatten 1,00. Dann haben wir sie mit einem Golden Set verglichen, das das Produktteam unabhängig geschrieben hatte. Das Modell stimmte in 6 von 12 Fällen damit überein: 50 %. Nach vier gezielten Korrekturen waren es 19 von 22 (86 %). Die 1,00 hatten nur gezeigt, dass wir gegen nichts Unabhängiges getestet hatten.
Dasselbe passierte mit Trainingsdaten aus Templates. Ein Modell, das hauptsächlich auf Templates trainiert war, schaffte 11 von 13 bei Testfällen, die wie die Templates aussahen, und 49 % bei echtem Traffic.
Was wir jetzt machen:
- Mehrere unabhängige Referenzen behalten und alle berichten: von Hand korrigierter echter Traffic, die Golden Cases des Produktteams und seine handgeschriebenen Testszenarien. Auf keiner davon je trainieren.
- Ein Test-Set versiegeln und die Blicke begrenzen. Wir schneiden es zeitlich, sodass es nur Traffic enthält, der neuer ist als alles im Training. Der Code erlaubt zwei Blicke darauf, und jeder Blick wird geloggt.
- Folds nach Konversation aufteilen, nicht nach Nachricht. Sonst landet eine Folgenachricht im Eval, während ihre erste Nachricht im Training liegt.
- Wissen, woran deine Baseline gemessen wird. Anfangs waren 70 % unserer Eval-Labels die Antworten des LLM selbst, nie von Hand geprüft. Auf diesem Teil lag das LLM per Definition immer richtig. Seine „94 %“ waren 100 % auf diesem Teil und 80 % auf den 324 Labels, die ein Mensch geprüft hatte.
Lektion 5: Echte Daten schlagen synthetische, auch geprüfte synthetische
Der größte einzelne Sprung kam von 344 echten, von Hand gelabelten Nachrichten: Die Genauigkeit auf echtem Traffic stieg von 49 % auf 82 %. Keine synthetischen Daten kamen auch nur in die Nähe.
Wir haben synthetischen Daten eine faire Chance gegeben. Ein LLM schrieb Beispiele für die seltenen Routen, und jedes musste eine Label-Prüfung durch die Jury bestehen, eine Prüfung gegen ein Teacher-Modell, eine Diversitätsprüfung und eine Mehrdeutigkeitsprüfung über die nächsten Nachbarn. Das Ergebnis war schlechter. Um denselben Recall auf den seltenen Routen zu erreichen, gab das Modell jetzt 5 Punkte Recall auf der häufigen Route ab (von 82,7 % auf 77,7 %). Die generierten Beispiele hatten korrekte Labels, lagen aber genau auf der Grenze, mit der das Modell ohnehin kämpfte, und machten sie noch unschärfer. Unsere billige Mehrdeutigkeitsprüfung hatte uns in Pilotläufen zweimal gewarnt. Wir hätten ihr beim ersten Mal glauben sollen.
Mehr von der häufigen Klasse hilft auch nicht. Eine Runde fügte 142 zusätzliche Beispiele für die häufige Route hinzu, und die Genauigkeit bei Small-Talk-Folgenachrichten fiel von 53 % auf 16 %.
Zähl also deine seltenen Klassen, bevor du irgendwas planst. Unsere seltenste Route kam auf etwa 1,25 gelabelte Beispiele pro Tag. Nach der vollen Historie von 90 Tagen hatten wir 45 davon zum Testen. Das ist zu wenig, um den Recall genau genug für eine Release-Entscheidung zu messen. Das behebt kein Modellierungstrick. Nur Zeit oder neue Datenquellen.
Lektion 6: Kleine statistische Fallen summieren sich
Jede davon hat eine Zahl verschoben, nach der wir gerade handeln wollten:
- Genauigkeit mit Gate kann ein schlechtes Modell durchwinken. Ein 17M erreichte mit Gate 93,3 %, lag aber bei den seltenen Routen in weniger als der Hälfte der Fälle richtig. Die schweren Fälle schickte es an den LLM-Fallback oder lag falsch, und die leichte Mehrheit trug den Wert. Berichte den Recall pro Klasse mit einer unteren Konfidenzgrenze, nicht nur die Schlagzeilenzahl.
- Ein Seed lügt. Unsere beste Konfiguration bestand mit einem Trainings-Seed jede Latte (92,96 %). Mit drei Seeds kam sie auf 90,5 bis 91,0 %. Die beste von mehreren Konfigurationen auf denselben Daten auszuwählen, ist der Fluch des Gewinners.
- Gestapelte Seeds täuschen Sicherheit vor. Drei Seeds zusammenzulegen verdreifacht die Zeilenzahl, ohne ein einziges neues Beispiel hinzuzufügen. Eine untere Grenze von 0,80 für eine seltene Klasse war in Wahrheit 0,74, als wir nur eindeutige Beispiele gezählt haben.
- Den echten Request-Pfad benchmarken. Eine frühe Angabe von rund 35 ms für das 68M war ein Batch-Durchschnitt. Einzelne Requests brauchten im Median 375 ms. Effizienzkerne waren 35 bis 40 % langsamer als Performance-Kerne, also leg die CPU fest, auf der du benchmarkst.
- Auf der Hardware vorhersagen, auf der du auslieferst. GPU-Vorhersagen in bfloat16 verschoben Wahrscheinlichkeiten um bis zu 0,03 gegenüber CPU in float32. Das reicht, um eine Schwelle zu verschieben.
Lektion 7: Modelle lernen Abkürzungen, also behebe Ursachen, nicht Symptome
Mehrere hartnäckige Fehler waren Abkürzungen, die das Modell in unseren Daten gefunden hatte:
- Jeder Gruppenname in den Trainingsdaten war in Großbuchstaben geschrieben, also lernte das Modell „Großbuchstaben bedeuten Gruppe“ und las großgeschriebene Artikelnamen falsch.
- Kein Negativbeispiel in einer Sprache erwähnte eine Gruppe, also wurde „diese Sprache plus ein Gruppenname“ zur Abkürzung für Ja.
- Jeder Gruppenname sah wie ein Eigenname aus, also wurde eine echte Gruppe übersehen, die mit einem gewöhnlichen, kleingeschriebenen Wort bezeichnet war.
Jede Korrektur war ein kleines, gezieltes Gegenbeispiel, gefunden durch Lesen genau der Eingaben, die scheiterten. Eine Regression lief über vier Runden, weil wir immer mehr Beispiele derselben Art hinzugefügt haben. Was funktioniert hat: das Beispiel zu löschen, das mit der anderen Klasse kollidierte. Wir haben auch gelernt, Schwankungen einer einzelnen Runde auf kleinen Test-Sets nicht hinterherzulaufen: Einem Muster sind wir erst nachgegangen, wenn es sich drei Runden lang beim selben Fall wiederholt hat.
Noch eine Falle: Schreib keine Trainingsdaten aus den Regeln des Prompts, den du ersetzt. Wir haben es einmal versucht. Unsere eigenen Testszenarien gingen auf 59 von 59, weil sie aus denselben Regeln geschrieben waren. Echter Traffic wurde schlechter, und die Fehler bei Folgenachrichten haben sich verdoppelt.
Der ganze Weg in einem Diagramm
Zwei Dinge haben die seltenen Routen bewegt: ein größeres Modell und mehr echte Daten. Die meiste clevere Datenarbeit hat sie seitwärts bewegt, und zwei Änderungen haben sie klar verschlechtert.
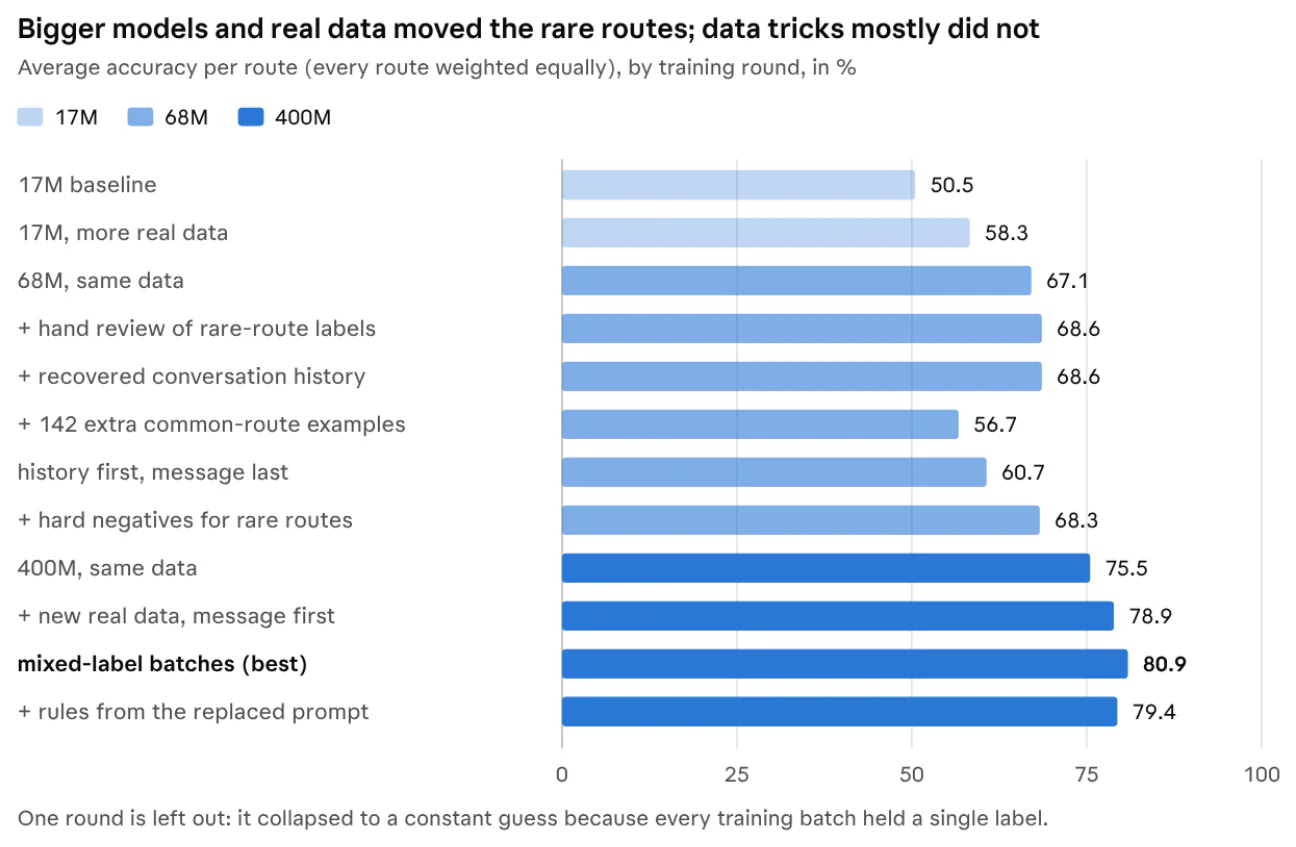
Bei rund 1.100 Testnachrichten trägt jede Gesamtzahl etwa ±2 Punkte Rauschen, die Zahlen für die seltenen Routen mehr. Mehrere Runden, die wir zuerst als Gewinne oder Verluste verbucht hatten, waren Rauschen. Peil rund 1.000 Eval-Zeilen an, bevor du an kleinen Änderungen iterierst, und lies Unterschiede von ein, zwei Punkten als Gleichstand.
Wenn du das selbst probierst
Für eine klar definierte Entscheidung ist ein kleines, feinjustiertes Modell eine starke Option. Es übernimmt nicht am ersten Tag, und fast jedes schwere Problem, auf das wir gestoßen sind, betraf Daten und Messung, nicht Modelle. Die Kurzfassung:
- Liste jedes Feld auf, das der LLM-Aufruf liefert, und jede Stelle, die es liest. Du sparst den Aufruf nur, wenn du ihn ganz ersetzt.
- Zähl deine seltenen Klassen im echten Traffic und rechne aus, wie viele Tage es dauert, genug davon zu sammeln.
- Hol Gold Labels von einer unabhängigen, blinden Jury, nicht von dem Modell, das du ersetzt.
- Leg die Latte fest, bevor du trainierst, und versiegle ein zeitlich getrenntes Test-Set.
- Fang bei einigen hundert Millionen Parametern an, wenn deine Klassen unausgewogen sind, und destilliere dann nach unten.
- Beurteile den Recall pro Klasse mit unteren Grenzen, bestätige ihn mit drei Seeds und benchmarke einzelne Requests auf der CPU, auf der du auslieferst.
- Zieh echte Daten synthetischen vor. Wenn du trotzdem Daten generierst, prüf sie früh und glaub den Prüfungen.
- Liefere hinter einem Confidence Gate mit LLM-Fallback aus, zuerst im Shadow Mode.
Lass das LLM die Antwort schreiben. Triff die Entscheidungen mit einem Modell, das du testen kannst.