Eine Software-Fabrik, die aus ihren eigenen Fehlern lernt
Wie ich zwei Gewohnheiten, agentisches Programmieren und ein Template für die Teile, die jede App braucht, zu einer Fabrik zusammengeführt habe: was die erste Version falsch gemacht hat, was ich geändert habe und wie jeder Fehler jetzt zurück ins Template fließt.
Lange Zeit habe ich zwei Dinge parallel gemacht. Ich habe Code mit Agents geschrieben, und ich habe ein Template-Repository gepflegt, in mehr als einem Framework, weil fast jede App, die ich gebaut habe, dieselben Teile gebraucht hat. Irgendwann war es nur logisch, beides zu verbinden. Das ist die Geschichte dieser Fabrik: die erste Version, was kaputtgegangen ist, was ich geändert habe und die Schleife, durch die sie immer besser wird.
Warum eine Fabrik bauen
Die meisten Business-Apps haben dasselbe Fundament. Login nur auf Einladung, Personen mit Rollen, ein Audit-Log, durchsuchbare Listen, zwei Sprachen, E-Mail- und Push-Benachrichtigungen und Tests auf jeder Ebene. Jede App setzt dann ihre eigenen Entitäten und Regeln obendrauf: Kunden, Planung, Stunden, Rechnungen.
Ich habe dieses Fundament jedes Mal neu gebaut und dieselben Lektionen immer wieder neu gelernt. Das Template hat den ersten Teil übernommen. Agents konnten viel vom Rest übernehmen, wenn ich ihnen etwas Solides gab, auf dem sie stehen können.
Die erste Version
Die erste Version war ein großer Agent, ein Template und ein Prompt. Es gab keine klaren Richtlinien und kein Issue-Tracking. Sie kam überraschend weit, und dann hat sie sich verlaufen: Fertige und halbfertige Arbeit sahen gleich aus, dasselbe wurde zweimal auf verschiedene Arten gelöst, und was sie gerade tat, konnte ich nur sehen, wenn ich mitlas.
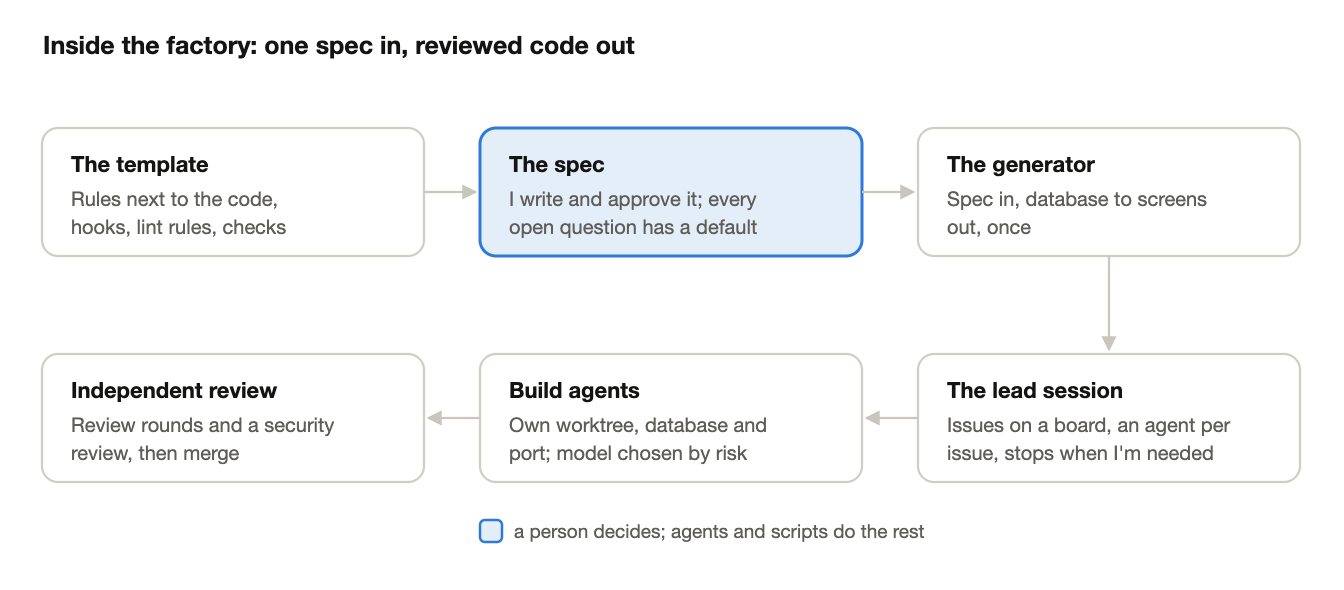
Seitdem ging es immer darum, Hoffnung durch Struktur zu ersetzen, ohne den Agents das zu nehmen, worin sie gut sind. Vier Änderungen haben den Großteil der Arbeit gemacht:
- Regeln direkt beim Code. Das Template sagt, wie man es erweitert, in Dateien, die die Agents lesen, und die Richtlinien sind fix, statt für jede App neu geschrieben zu werden.
- Ein deterministischer Generator. Alles Vorhersehbare schreibt ein Skript aus einer typisierten Spec, einmal.
- Issues und eine Lead-Session. Die Arbeit wird in Issues auf einem Board aufgeteilt, und eine koordinierende Session verteilt sie an Build-Agents und merged die Ergebnisse.
- Unabhängige Reviewer. Ein Agent darf seine eigene Arbeit nicht für fertig erklären.
Eine Spec, einmal generiert
Alles beginnt mit einer typisierten Datei, app.spec.ts. Ich schreibe sie zusammen mit einem Agent und genehmige sie selbst; sie ist der eine Ort, an dem entschieden wird, was die App tun soll. Sie nennt die Entitäten, ihre Felder, welche Rolle was lesen oder schreiben darf, und die Screens.
export default defineApp({
  name: 'Example app',
  roles: { is_planner: 'Planner', is_finance: 'Finance' },
  entities: {
    customer: {
      fields: {
        name: text({ required: true, max: 200 }),
        payment_terms_days: int({ min: 0, max: 120, default: 30 }),
        billing_email: email(),
      },
      read: ['is_planner', 'is_finance'], write: ['is_planner'],
      screens: { list: { columns: ['name'], search: ['name'] }, detail: true, form: true },
    },
  },
});
Ein Feldtyp ist eine Regel aus dem Template, als Deklaration geschrieben. money ist immer ganzzahlige Cent, nie ein Float. choice ist eine gemeinsame Vokabular-Tabelle mit einer Auswahl, nie Freitext. Jeder Typ kennt seine Datenbankspalte, seinen CHECK-Constraint, sein Formularfeld, seine Listenzelle, seinen Formatter und seine Testwerte.
Aus dieser Spec schreibt der Generator pro Entität:
- die Migration, mit Row-Level Security ab der ersten Zeile
- eine Speicher- und eine Löschfunktion, der einzige Weg zu schreiben, und jede schreibt ihren Audit-Eintrag in derselben Transaktion
- Datenbanktests, Zeilen in der Zugriffsmatrix und eine Performance-Messung
- die Listenseite, die Datensatzseite, das Formular, eine Gruppe in der Command-Palette, Fehlermeldungen und jeden Text in jeder Sprache
- Unit-, Integrations- und End-to-End-Tests sowie Demodaten
Er generiert einmal. Danach ist der generierte Code ganz normaler Code, den Agents wie alles andere erweitern. Zuerst habe ich eine Maschinerie gebaut, die Code neu generiert und dabei Handänderungen behält, und sie dann wieder gelöscht. Zwei Quellen der Wahrheit synchron zu halten hat mehr gekostet, als es gebracht hat.
Die Lead-Session und ihre Agents
Den Build steuert eine koordinierende Session pro App. Sie nimmt bereite Issues vom Projekt-Board, startet für jedes einen Build-Agent und merged jeweils einen reviewten PR nach dem anderen. Sie meldet sich bei mir nur, wenn ein Mensch gebraucht wird. GitHub hält den gesamten Zustand: das Board, die Issues, die PRs und ein Report-Issue pro Durchlauf. Es gibt kein Orchestrierungs-Framework, kein Planer-Skript und keine State-Datei. Ein Neustart der Lead-Session verliert nichts.
Jeder Agent arbeitet in seinem eigenen Slot. Ein Slot ist ein Git-Worktree, ein isolierter lokaler Supabase-Stack und ein eigener Port. Drei Agents können nebeneinander bauen, migrieren und ihre Testsuites laufen lassen, ohne die Daten der anderen anzufassen. Ein Laptop schafft höchstens drei gleichzeitig.
Modell nach Risiko. Die Lead-Session plant mit dem stärksten Modell. Normale Issues werden mit einem schnelleren, günstigeren Modell gebaut. Alles, was Security, Row-Level Security, Auth, Geld, Verträge oder Migrationen bestehender Tabellen berührt, wird von Anfang an mit dem stärksten Modell gebaut.
Eskalation ist eine Tabelle, keine Ermessensfrage:
| Wann | Normales Issue | Kritisches Issue |
|---|---|---|
| Derselbe Schritt ist zweimal fehlgeschlagen | auf das starke Modell wechseln | n/a |
| Ein blockierender Befund nach 3 Review-Runden | auf das starke Modell wechseln | n/a |
| Der Diff berührt einen Hochrisikobereich | auf das starke Modell wechseln | n/a |
| Derselbe Schritt ist 3 Mal fehlgeschlagen | anhalten, einen Menschen fragen | anhalten, einen Menschen fragen |
| Eine Frage, die nur ein Mensch beantworten kann | anhalten, einen Menschen fragen | anhalten, einen Menschen fragen |
Jeder PR durchläuft eine Review-Schleife. Der Agent macht Code-Review-Runden, bis eine Runde keinen kritischen oder schweren Befund mehr hat, höchstens drei Runden. Ein schwerer Befund, der danach noch offen ist, wird ein eigenes Issue und im PR genannt. Befunde zu Security, Zugriffskontrolle, Datenverlust und Migrationen sind nie gedeckelt: Die werden behoben, egal wie viele Runden es braucht. Vor jedem Merge läuft auf demselben Diff ein separates Security-Review.
Offene Fragen blockieren nie einen Build. Jede Frage in der Spec kommt mit einem Default. Der Agent baut den Default und protokolliert die Frage, und ein Mensch bestätigt oder ändert ihn später.
Leitplanken: warum ich dem vertrauen kann, was Agents bauen
Agents machen selbstsichere Fehler, also ist die Fabrik so gebaut, dass Fehler laut werden und die gefährlichen unmöglich sind.
- Die Datenbank hält die Regeln. Jede Tabelle hat Row-Level Security ab der Migration, die sie anlegt. Jeder Schreibzugriff mit einer Geschäftsregel geht über eine Funktion pro Entität, und die Rolle wird immer serverseitig nachgeschlagen, nie vom Client übernommen. Ein UI-Bug kann keine Regel umgehen, weil die UI nie eine durchsetzt.
- Ein Vollständigkeitstest. Jede Tabelle, jede View und jede Funktion muss in einer Zugriffsmatrix stehen und von Datenbanktests abgedeckt sein. Wer eine Tabelle anlegt und ihre Policy vergisst, bekommt einen fehlgeschlagenen Build.
- Hooks, die blockieren, und Hooks, die informieren. Zwei frühe Fehlerquellen waren Tests, die still übersprungen wurden, und Bugs, bei denen ein Agent eine Funktion geändert hat, ohne alles zu kennen, was sonst noch davon abhing. Hooks legen dem Agent diesen Kontext jetzt vor, bevor er etwas ändert, und verweigern die Aktionen, die die Regeln verbieten, bevor sie laufen. Dazu gehören das Lesen geheimer Env-Dateien, das Ändern einer Migration, die schon auf dem Main-Branch ist, direktes Pushen auf die gehostete Datenbank, breite Process-Kills und Git-Operationen im Haupt-Checkout, während Agents arbeiten.
- Konventionen sind Lint-Fehler. Keine hartcodierten Farben, keine rohe Datumsformatierung, kein unübersetzter Text, kein toter Code. Ein End-to-End-Test prüft außerdem, dass keine Seite auf Desktop- oder Handybreite überläuft. Eine Regel, die eine Maschine prüfen kann, wird nicht dem Review überlassen.
- Jede Testebene, bei jeder Änderung. Unit-Tests, Datenbanktests, eine Integrationssuite gegen einen lokalen Stack und Browser-Tests. „Fertig“ heißt, der komplette Check läuft durch, nicht, dass der Agent sagt, er sei fertig.
Die Fabrik lernt aus jedem Projekt
Jedes Projekt endet mit einer Liste dessen, was schiefgegangen ist, und diese Liste ändert das Template, bevor das nächste Projekt beginnt. Diese Schleife ist wichtiger als jedes einzelne Feature der Fabrik.
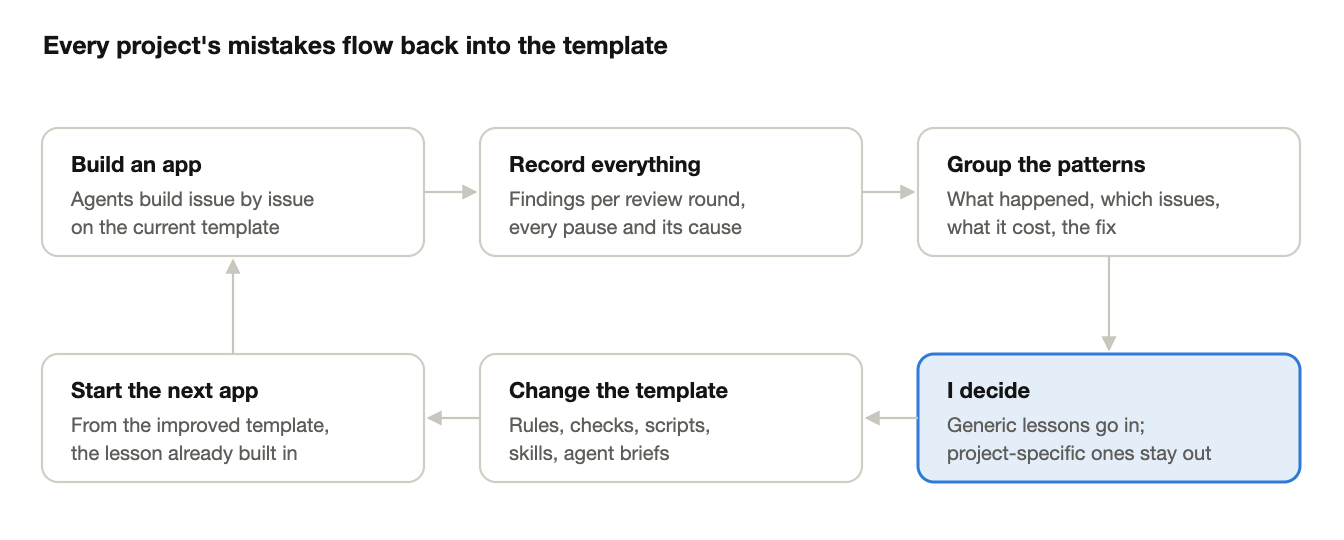
Aufzeichnen. Während ein Durchlauf läuft, protokolliert ein lokales Arbeitsboard jede Statusänderung jedes Issues, jede Review-Runde mit ihren kritischen, schweren und leichten Befunden und jede Pause mit ihrem Grund. In einem Durchlauf einer App waren das 93 Issues und 148 Review-Runden: 3 kritische, 182 schwere und 737 leichte Befunde. Der Durchlauf hat 18 Mal pausiert: 11 Mal wegen Nutzungslimits und 7 Mal wegen einer hängenden Docker-VM.
Gruppieren. Am Ende des Durchlaufs macht der Koordinator aus diesem Protokoll eine Liste von Mustern statt von Einzelfällen. Jeder Eintrag hat vier Teile: was passiert ist, welche Issues betroffen waren, was es an Runden oder Stunden gekostet hat und die vorgeschlagene Lösung. Nur allgemeine Lektionen kommen hinein. Alles, was nur eine App betrifft, bleibt in dieser App.
Entscheiden und ändern. Ich lese die Liste und entscheide, was ins Template kommt. Das Template führt eine eigene Liste von Verbesserungen, gespeist aus bisher vier Projekten, und arbeitet sie in Wellen ab. Jede Lektion landet als das Stärkste, was passt: eine Datenbankregel, ein Lint-Fehler, ein Check-Skript, ein Hook oder eine Zeile im Briefing eines Agents.
Was schiefgegangen ist, gruppiert
Das sind die Muster aus vier Projekten, sortiert nach dem, was sie gekostet haben. Jedes endet damit, was es an der Fabrik geändert hat.
1. Review-Schleifen, die nicht konvergieren
Ein Rechnungs-Issue lief 25 Review-Runden mit 162 Befunden und hat ungefähr 12 Stunden Agent-Zeit gekostet, das meiste davon nach Runde 10. Das Issue hat mehrere schwierige Probleme in eine Migration gepackt: lückenlose Rechnungsnummern, Gutschriften pro USt-Gruppe und Bündel. Jeder Fix hat neue Randfälle aufgemacht. Gemeinsame Regeln, an die es sich hätte halten sollen, sind erst mitten im Review aufgetaucht.
Was sich geändert hat: Die Schleife ist auf drei Runden gedeckelt, und übrig gebliebene nicht blockierende schwere Befunde werden eigene Issues. Befunde zu Security, Zugriff, Datenverlust und Migrationen bleiben ungedeckelt. Ein Issue, das mehrere schwierige Probleme mischt, wird aufgeteilt, bevor jemand es baut, und die harten Regeln kommen ins Briefing des Agents, bevor die erste Zeile geschrieben ist.
2. Das eigene Review eines Agents reicht nicht
Bei den PRs rund ums Geld haben die eigenen Review-Runden der Agents die Arbeit immer wieder für sauber erklärt. Ein unabhängiges Review hat dann trotzdem schwere Befunde gefunden: verlorene Updates, versteckte Zeichen, fehlende Locks. Ein PR hatte vier schwere Befunde nach neun Runden, deren letzte zwei sauber gewesen waren.
Was sich geändert hat: ein unabhängiges Review bei Hochrisiko-PRs, mit einer Checkliste aus den häufigsten Befundarten: Nebenläufigkeit, Datenintegrität und Autorisierung.
3. Nebenläufigkeit
Eine neue Geldfunktion hat sich mit bestehenden Planungs- und Stundenfunktionen gegenseitig blockiert, weil jede Zeilen in ihrer eigenen Reihenfolge gesperrt hat. Eine andere Race Condition hat es erlaubt, eine Einstellung zwischen einer Prüfung und dem Schreiben abzuschalten.
Was sich geändert hat: eine globale Lock-Reihenfolge, Locks ganz oben in der Funktion, und ein Setter, von dem eine Prüfung abhängt, nimmt einen Lock, der mit dieser Prüfung kollidiert.
4. Dieselbe Regel, zweimal implementiert
Agents haben eine zweite USt-Berechnung, eine zweite Retry-Schleife und einen zweiten Textnormalisierer geschrieben. In jedem Fall gab es schon einen Helper, aber nichts hat sie aufgelistet, oder der Helper eines parallelen Agents war noch nicht gemerged.
Was sich geändert hat: eine Seite mit gemeinsamen Helpern („dafür nimm das“), durch einen Test aktuell gehalten. Agents schauen dort nach, bevor sie bauen. Ein Issue, das einen noch nicht gemergten Helper eines anderen Agents braucht, wartet darauf, statt einen Ersatz zu schreiben.
5. Parallele Arbeit kollidiert
Fast jeder PR musste seine Migration ein- oder zweimal umnummerieren, weil sich der Base-Branch bewegt hat, insgesamt etwa 55 Minuten über fünf Issues.
Was sich geändert hat: Ein Skript nummeriert die Migrationen eines Branches um und listet die Funktionen auf, die sie neu anlegen und die die Base inzwischen geändert hat. Es läuft vor jedem PR.
6. Tests, die von anderen Tests abhängen
Datenbanktests und Browser-Tests teilen sich einen Stack, also ist ein Test, der „alle Zeilen“ gezählt hat, fehlgeschlagen, nachdem die Browser-Tests welche hinzugefügt hatten. Die „neueste“ Zeile nach Erstellungszeit auszuwählen ist fehlgeschlagen, wenn mehrere Zeilen in einer Transaktion angelegt wurden.
Was sich geändert hat: Jeder Datenbanktest beschränkt sich auf seine eigenen Fixture-IDs und geht nie von einer leeren Tabelle aus.
7. Bugs, die jede neue App hatte
Tests haben Styling festgenagelt statt Verhalten. Tooling ist kaputtgegangen, wenn jemand eine Zeile umgebrochen hat. Der Dev-Server hat eine Config-Datei umgeschrieben. Die eigene Farbpalette des Templates ist bei neun Kontrastpaaren durchgefallen.
Was sich geändert hat: Tests nageln Verhalten fest, und ein Kontrast-Check läuft über jedes Farbpaar im Light- und Dark-Mode. Token-, Icon- und Theme-Generierung sind Skripte geworden.
8. Der Laptop ist ein Flaschenhals
Drei Agents, jeder mit eigenem Datenbank-Stack und eigenen Testläufen, haben die Maschine überlastet. In einem Durchlauf hat die Fabrik 11 Mal wegen Nutzungslimits und 7 Mal wegen einer hängenden Docker-VM pausiert.
Was sich geändert hat: Limits pro Slot für Test-Worker und Build-CPUs, schlankere Datenbank-Stacks, und Agents stoppen ihren Stack, sobald ihr PR offen ist.
9. Lektionen zum Prozess
- Ein separater Reviewer-Agent hat eine Übergabe hinzugefügt, aber keine Qualität, also reviewt der Builder seine eigene Arbeit, und das unabhängige Review bleibt für Hochrisiko-Änderungen.
- Meinen manuellen Koordinations-Workflow einfach so zu übernehmen, wie er war, hat besser funktioniert als ein neues Harness zu entwerfen.
- Ich konnte nicht sehen, was die Lead-Session tut, ohne das Terminal zu lesen. Daraus ist ein lokales Arbeitsboard entstanden, das zeigt, was mich braucht, welche Fragen warten, die Bahnen der Agents und wie lange jedes Issue gedauert hat.
Noch offen
Die Schleife läuft mit Verzögerung. Der Runden-Deckel, das Umnummerieren der Migrationen, die Regel zur Testisolation, die Laptop-Limits und das Arbeitsboard sind im Template. Die Lock-Reihenfolge, die Helper-Seite und das unabhängige Review haben sich in dem Projekt bewährt, aus dem sie kommen, sind aber noch nicht ins Template gewandert. Was noch kommt: ein Check, der bei nicht eingeschränkten Zeilenzählungen in Datenbanktests fehlschlägt, und ein Copy-Paste-Detektor.
Die Fabrik läuft vorerst auf einem Laptop. Nichts in ihr setzt das voraus, und Cloud-Sessions sind der nächste Schritt.
Was ich jemandem sagen würde, der eine baut
- Leg die Regeln dorthin, wo Agents sie nicht überspringen können. In die Datenbank, in Lint-Regeln, in Hooks. Eine Regel, die nur in einem Prompt steht, ist ein Vorschlag.
- Lass Menschen die Entscheidungen treffen. Agents sind gut zwischen den Entscheidungen, nicht darin, sie zu treffen. Gib jeder offenen Frage einen Default, damit nichts wartet.
- Miss jede Review-Runde. Ohne Zahlen hätte ich das Issue mit 25 Runden „ein schwieriges“ genannt. Mit ihnen konnte ich sehen, dass die meisten Runden nach Runde 10 leichte Befunde waren und das Issue drei Issues hätte sein sollen.
- Bleib deterministisch, aber kämpf nicht gegen die Agents. Skripte, was vorhersehbar ist. Wer Skripte über die Arbeit zwingt, in der Agents am besten sind, macht genau den Teil kaputt, der sie wertvoll macht.
- Behandle jedes Projekt als Input. Das wertvollste Ergebnis eines Projekts ist die Liste dessen, was schiefgegangen ist, und sie ist erst dann etwas wert, wenn sie das Template ändert.
In Zahlen
| Template-Historie | ~480 Commits, 151 gemergte PRs, 184 geschlossene Issues seit Februar 2026 |
| Testsuite | ~5.600 Unit-Tests, 57 Datenbank-Testdateien, 36 Browser-Specs |
| Datenbank | 92 Migrationen, jede Tabelle in der Zugriffsmatrix |
| Ein Durchlauf einer App | 93 Issues, 148 Review-Runden; 3 kritische, 182 schwere, 737 leichte Befunde |
| Projekte, die das Template speisen | 4 |