Roboter scheitern nicht allein
Ich habe eine Browser-Simulation autonomer Roboter gebaut, die Paletten durch eine Logistikhalle fahren, mit echten Fahrzeugdaten und einer kleinen Geschäftsebene darüber. Hier ist, was sie mir über Systeme beigebracht hat.
Einmal standen in meiner Simulation zwei Roboter dreißig simulierte Minuten lang Nase an Nase. Keiner war kaputt. Jeder wartete, völlig korrekt, darauf, dass der andere sich bewegt. Keine Codezeile sagt „Deadlock“. Er entstand aus dem Layout, den Sicherheitsregeln und dem Verkehr, alles auf einmal.
Dieser Moment fasst das meiste zusammen, was ich gelernt habe. Jeder Teil der Simulation war für sich einfach und korrekt. Die interessanten Fehler passierten zwischen den Teilen.
Einfach aussehen lassen, die Zahlen echt halten
Die Simulation sieht aus wie ein Spielzeug: weiche Schattierung, Umrisse, klobige Roboter. Darunter kommen die Zahlen aus Datenblättern. Fahrzeuggröße, Fahr- und Hubgeschwindigkeit, Hubhöhe, Reichweite und Winkel der Sicherheitslaserscanner, Palettenmaße, die Größe eines Standardaufliegers und die Gangbreiten, die ein echter Standort planen würde. Wo ich keinen veröffentlichten Wert finden konnte, habe ich geschätzt und dazugeschrieben, dass es eine Schätzung ist.
Diese Trennung hat besser funktioniert als erwartet. Niemand beurteilt eine Simulation danach, wie fotorealistisch sie ist. Man beurteilt sie danach, ob ein Roboter so lange braucht, wie man es erwarten würde, um die Halle zu durchqueren, eine Palette ins oberste Fach zu heben und aus einem Regal zurückzusetzen. Stimmen diese Zahlen, vertrauen die Leute dem Rest. Schätzungen als Schätzungen zu kennzeichnen hat sie glaubwürdiger gemacht, nicht weniger, weil es zeigt, dass du weißt, wo die Lücken sind.
Realismus steckt in den Zahlen, nicht in der Grafik. Sag, wo du geschätzt hast.
Deadlocks sind oft Geometrie
Mein schlimmster Bug sah nach einem Verkehrsproblem aus. Roboter, die an zwei Rücken an Rücken stehenden Regalfächern arbeiteten, froren manchmal ein. Der Sicherheitsscanner jedes Roboters hat ein Schutzfeld: einen Bereich vor dem Fahrzeug, in dem jedes Hindernis Stopp bedeutet. Fuhr ein Roboter in sein Fach, reichte sein Feld durch die Lücke ins Nachbarfach. Stand dort ein anderer Roboter, sahen beide ein Hindernis, beide hielten an, und keiner bewegte sich je wieder.
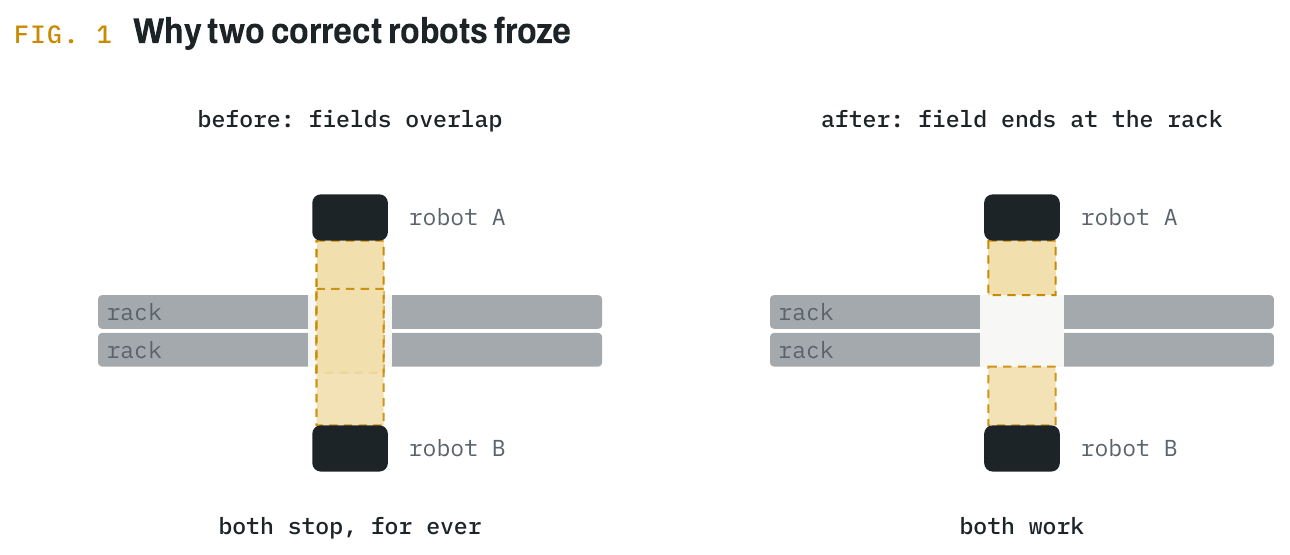
Ich hätte klügeren Verkehrscode schreiben können: Prioritäten, Back-off-Timer, einen Vermittler. Die Lösung war stattdessen eine einzige Regel: Beim Andocken an ein Regal endet das Feld am Regal. Der Roboter schützt weiterhin alles in seinem eigenen Gang, und er reagiert nicht mehr auf einen Nachbarn, den er nie erreichen könnte.
Wenn du Software schreibst, kennst du diesen Bug als zwei Threads, die gegenseitig ihre Locks halten. Wenn du Standorte planst, kennst du ihn als zwei Gänge, die jeder für sich passen und zusammen verstopfen. So oder so liegt die Lösung oft darin, die Form des Problems zu ändern, statt noch mehr Cleverness obendrauf zu setzen.
Ein System, das sich nicht erholen kann, geht unter
Die erste Version der Geschäftsebene hatte einen stillen Fehler. Aufträge, die nicht bedient werden konnten, warteten einfach. Schickten Kunden mehr Arbeit, als die Roboter schaffen konnten, wuchs die Warteschlange, jeder Auftrag darin war verspätet, und der Betrieb holte nie auf, selbst nachdem die Nachfrage gesunken war. Im echten Leben warten Kunden nicht ewig. Sie stornieren und gehen woanders hin.
Also habe ich genau das eingebaut: Ein Auftrag, den nach 20 Minuten niemand begonnen hat, wird zurückgezogen. Er bringt nichts ein und zählt als verspätet, aber er verlässt die Warteschlange. Um zu sehen, was das bewirkt, habe ich den kleinen Startstandort mit einem Roboter und 70 Aufträgen pro Stunde noch einmal laufen lassen, was fast genau dem entspricht, was dieser Roboter schafft, einmal mit und einmal ohne die Regel.
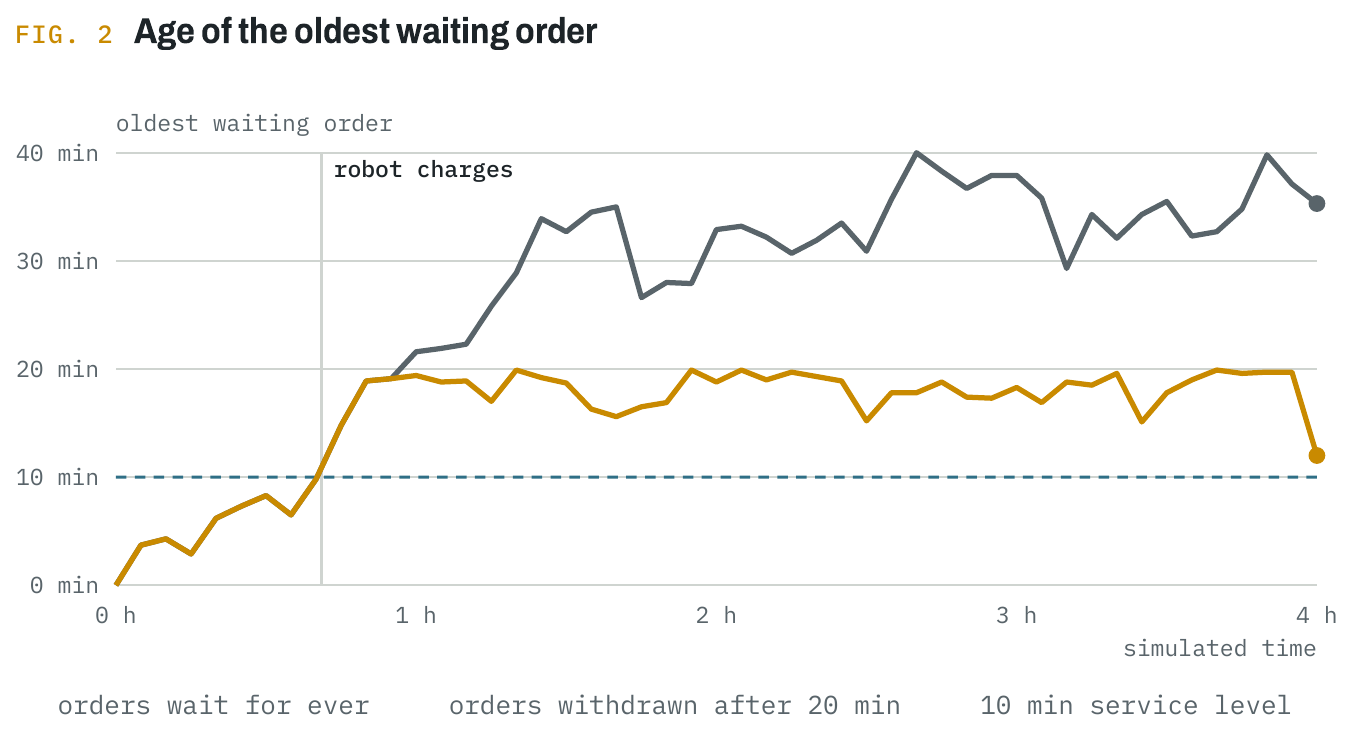
Der Lauf zeigt etwas, das ich nicht erwartet hatte. In den ersten 40 Minuten ist alles pünktlich. Dann, bei 41 Minuten, fährt der Roboter für etwa eine Viertelstunde zum Laden. In dieser Zeit springt die Warteschlange von 15 auf 31 Aufträge, und weil der Roboter ungefähr an seiner Kapazitätsgrenze läuft, holt er diese Zeit nie wieder auf. Ohne Zurückziehen bleibt der älteste Auftrag die nächsten drei Stunden 30 bis 40 Minuten alt, und kein einziger Auftrag ist mehr pünktlich. Ein routinemäßiger Ladestopp hat über den Rest der Schicht entschieden.
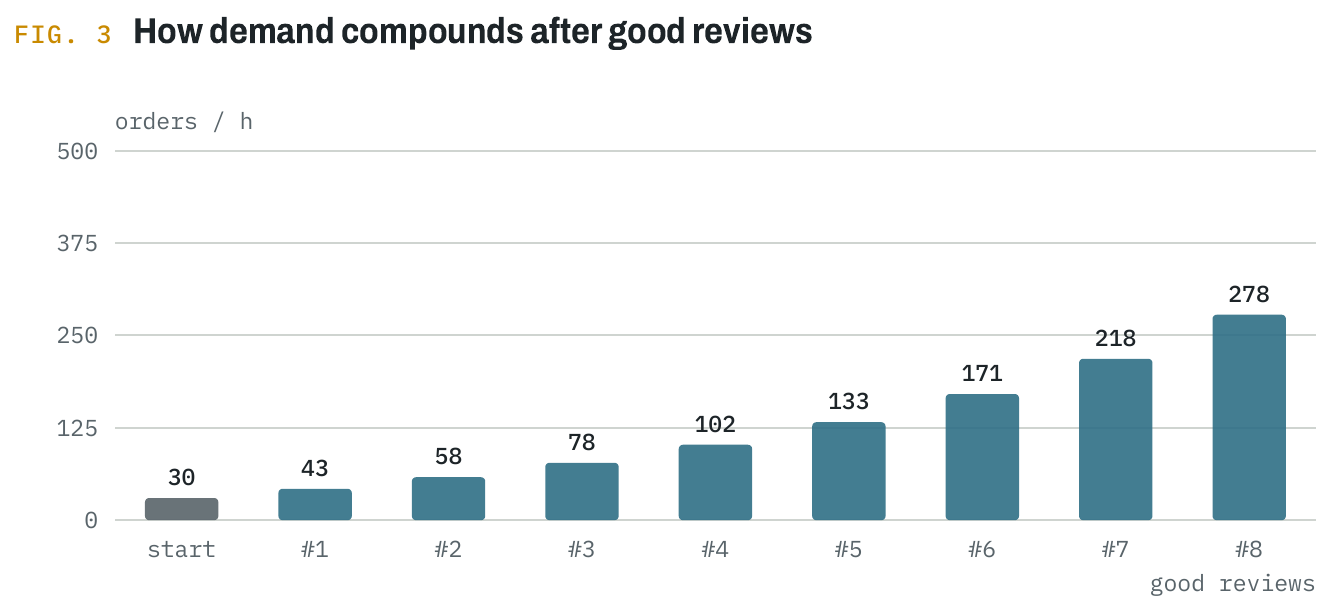
Mit Zurückziehen wird der älteste Auftrag nie älter als 20 Minuten, und die Warteschlange endet bei 19 statt bei 34. Das begrenzt den Schaden, bringt aber die Pünktlichkeit nicht zurück: Der Roboter bedient weiterhin Aufträge, die schon verspätet sind. Die echte Erholung braucht eine zweite Schleife, und in der Simulation ist das der Kunde: Nach einer schlechten Bewertung schickt er 15 % weniger Aufträge, und das gibt der Flotte den Spielraum zum Aufholen. Wer mit 100 % fährt, hat keinen Puffer, um auch nur eine geplante Unterbrechung abzufangen.
Ein System an der Kapazitätsgrenze kommt von einer kleinen Verzögerung nicht mehr zurück. Lass Spielraum, und gib der Überlast einen Ausweg.
Der umgekehrte Fall ist genauso wichtig. Kunden in der Simulation bewerten den Standort alle 30 Minuten und schicken mehr Arbeit, wenn es gut lief. Das hieß, ein Spieler mit untätigen Robotern musste herumsitzen und auf die nächste Bewertung warten. Ihn jederzeit um mehr Arbeit bitten zu lassen, in kleinen Schritten und nur, solange die Warteschlange kurz ist, hat den Stillstand beseitigt. Beide Lösungen drehen sich um dasselbe: Plane den Weg aus der Überlast und aus der Unterlast, denn beides bringt den ganzen Betrieb zum Stehen.
Den Engpass benennen
Simulationen erzeugen jede Menge Zahlen: Auslastung, Länge der Warteschlange, Zykluszeit, Füllgrad, Belegung der Ladestationen. Ich hatte ein Panel für alle, und es hat niemandem bei der Entscheidung geholfen, was zu tun ist. Geholfen hat eine einzige Textzeile, die den gerade schlimmsten Engpass nennt und die Maßnahme dagegen: Regale, die Roboter nicht erreichen, Aufträge, die kein Roboter übernehmen darf, eine Schlange an der Ladestation, fast leere Regale.
Diese Zeile auszuwählen zwingt dich, die Probleme zu reihen, und genau diese Arbeit überlässt ein Dashboard dem Leser. Das ist weit über Simulationen hinaus nützlich. Jedes Monitoring wird besser, wenn es zuerst die Frage „Was bremst uns gerade am meisten?“ beantwortet, bevor es die hundert Dinge zeigt, die es messen kann.
Ein Skript den Betrieb führen lassen
Um zu prüfen, ob sich der ganze Spielverlauf tatsächlich abschließen lässt, habe ich einen geskripteten Spieler geschrieben, der nur tut, was die Simulation selbst vorschlägt: dem aktuellen Ziel folgen, auf die Engpasszeile reagieren, sonst nichts. Mit drei Seeds hat er alle zwölf Ziele in 5 bis 8,5 simulierten Stunden geschafft.
Dieser Lauf beweist, dass der Weg existiert. Er beweist nicht, dass der Weg gut ist, und ich finde, dieser Unterschied ist für jeden automatisierten Test wichtig. Das Skript hat auch Dinge gezeigt, die ich beim Herumklicken nicht gefunden hätte: Spät im Lauf häufte sich Geld an, für das es nichts zu kaufen gab, vier oder fünf Roboter reichten auf diesem kleinen Standort für 200 Aufträge pro Stunde, und ein Lauf verlor eine halbe Stunde, weil sich zwei Roboter frontal blockierten, was sich von selbst auflöste. Aus jedem davon wurde eine Änderung.
In Schichten bauen
Die Reihenfolge der Arbeit hat das alles möglich gemacht. Bevor ich irgendeinen Realismus eingebaut habe, habe ich die Simulation in getrennte Systeme hinter einer Schnittstelle aufgeteilt und ihr Verhalten mit Golden Tests festgenagelt, die einen festen Seed abspielen und das Ergebnis vergleichen. Dann wanderten die Fahrzeugdaten in eine austauschbare Spezifikation. Dann kamen Sicherheit, Routing und Lokalisierung jeweils hinter eine eigene Schnittstelle.
Erst danach kamen die schwierigen Teile: Sicherheitsscanner mit Raycasting, Navigation in beliebigen Winkeln, Lokalisierung per Scan-Matching gegen eine Karte der Halle. Jeder davon ersetzte einen einfachen Platzhalter, und jeder landete, ohne den Rest kaputtzumachen, weil die Tests genau sagten, was sich geändert hatte. Eine Simulation ist ein System aus Systemen. Sie auch so zu bauen hat es überhaupt erst möglich gemacht, sie realistisch zu machen.
Die Überlast-Abbildung stammt aus einem Headless-Lauf der Simulation mit einem Seed und einem kleinen Layout, nimm sie also als Form des Effekts und nicht als allgemeinen Benchmark. Die Nachfragekurve ist aus der Regel des Spiels berechnet.